IA en langues africaines : le vrai goulot d’étranglement, ce n’est plus le calcul, ce sont les données
La start-up sud-africaine Vambo AI a entraîné MORENA, un modèle couvrant douze langues africaines, grâce à un supercalculateur prêté gratuitement. Le plus dur a été de trouver du texte. Une leçon pour tout l’écosystème.
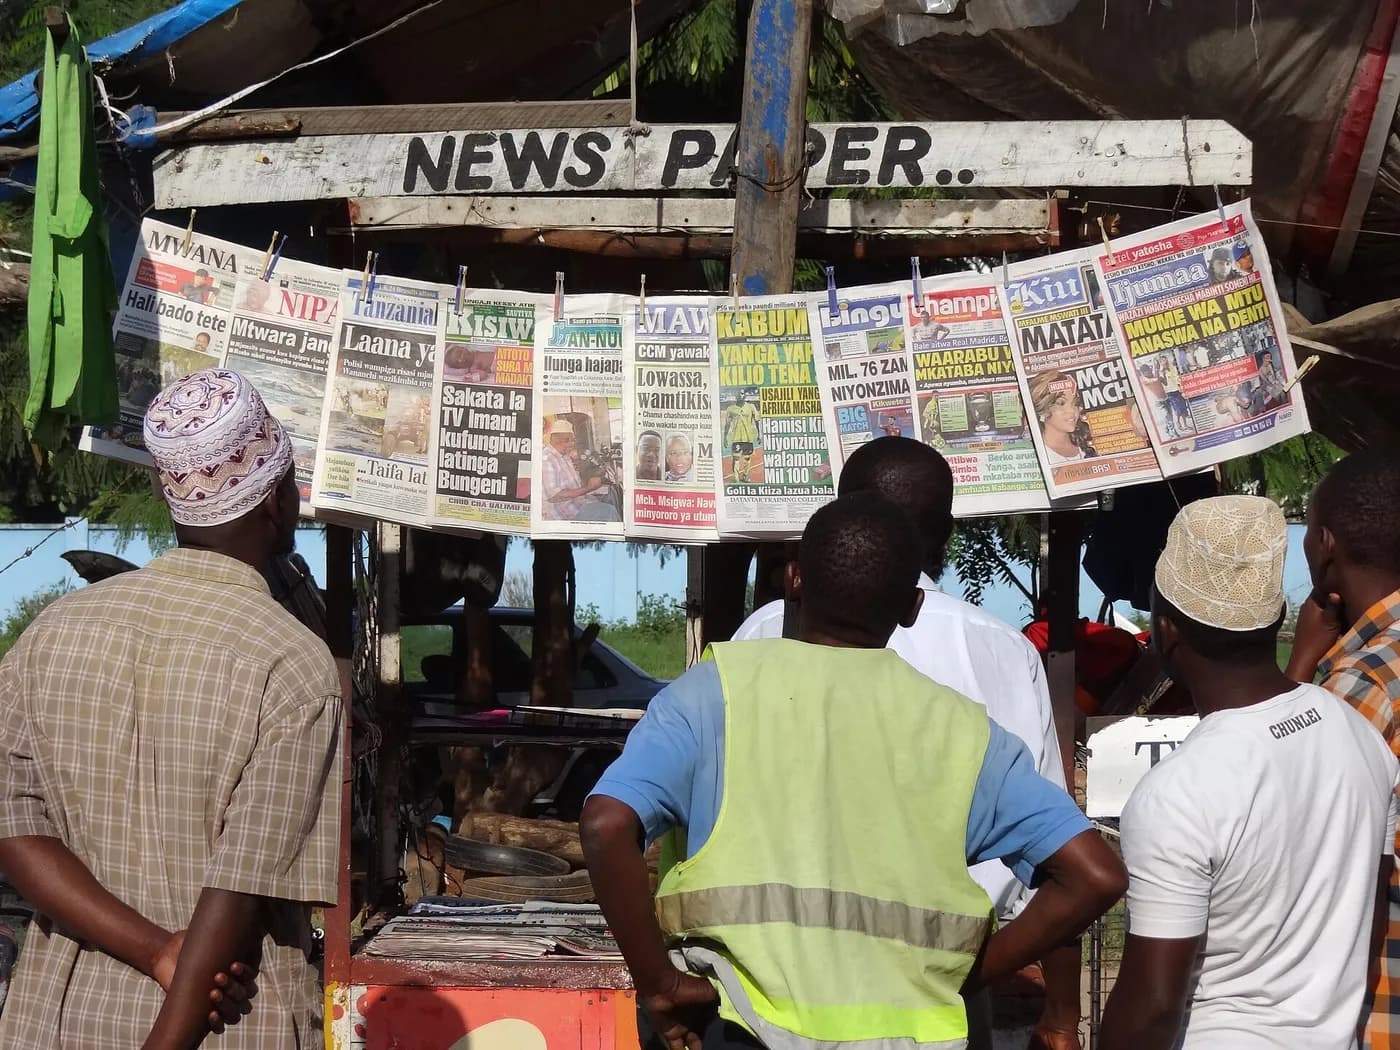
- Vambo AI (Afrique du Sud) a entraîné MORENA, un modèle de 1,5 milliard de paramètres couvrant douze langues africaines.
- Le calcul a été offert (supercalculateur Leonardo du CINECA via le PNUD) ; le vrai obstacle a été le manque de textes.
- Une grande partie des données est synthétique, avec une grammaire parfois imparfaite.
- Les poids sont publiés sous licence Apache 2.0 pour que d’autres développeurs l’adaptent.
Quand la start-up sud-africaine Vambo AI a entrepris de construire MORENA, un modèle d’intelligence artificielle de 1,5 milliard de paramètres couvrant douze langues africaines, elle a réglé le problème que tout le monde croyait le plus difficile : la puissance de calcul. Grâce à un programme soutenu par le PNUD, elle a eu accès à un supercalculateur. Le véritable obstacle est venu ensuite : trouver assez de textes écrits dans ces langues.
« Trouver autant de données réelles était presque impossible, donc une grande partie était synthétique. »
Isheanesu Misi, cofondateur et directeur technique de Vambo AI, à TechCabal
Un modèle pour douze langues
MORENA couvre le chishona, le kiswahili, le haoussa, le yoruba, l’igbo, l’isizoulou, l’isixhosa, le kinyarwanda, le setswana, l’afrikaans, l’isindebele et le pidgin nigérian, en plus de l’anglais, du français et du code informatique. Selon sa documentation, il a été entraîné sur 251,7 milliards d’unités de texte, dont 65,6 milliards en langues africaines.
Vambo a choisi d’entraîner son modèle à partir de zéro, plutôt que d’adapter un modèle existant. La raison : les modèles généralistes héritent souvent de faiblesses dans leur façon de découper et de traiter les langues africaines. Le résultat, selon l’entreprise, est un modèle performant sur les textes africains : sur les douze langues, MORENA obtient le meilleur score de modélisation du texte parmi 26 modèles testés, y compris des modèles bien plus grands.
Un détail technique illustre l’enjeu. Un modèle d’IA découpe le texte en petits morceaux avant de le traiter, et chaque morceau a un coût de calcul. Le découpeur de MORENA représente les textes africains avec 1,39 fois moins de morceaux que celui du modèle Gemma 3 de Google, et 1,53 fois moins que celui de Llama 3.2 de Meta. Pour un utilisateur, cela signifie des réponses plus rapides et moins chères dans ces langues.
Données d’entraînement de MORENA
En milliards d’unités de texte. Source : Documentation du modèle, via TechCabal
Le supercalculateur, offert
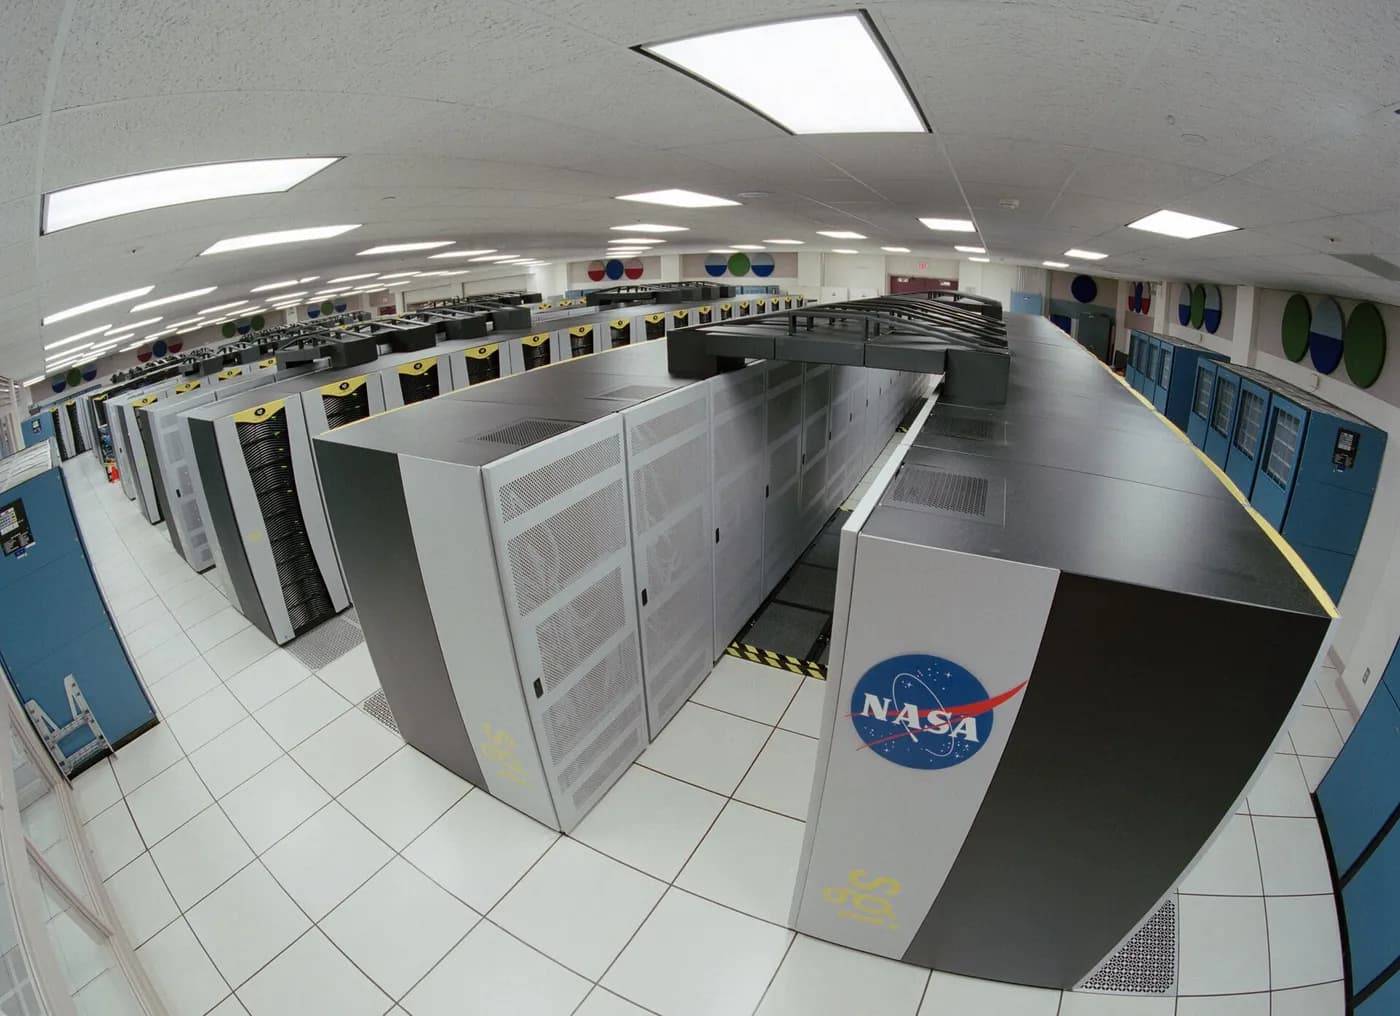
Vambo n’a rien payé pour la puissance de calcul. Le consortium universitaire italien CINECA, spécialiste du calcul haute performance, lui a donné accès à son supercalculateur Leonardo, par l’intermédiaire de l’AI Hub for Sustainable Development du PNUD. Certains entraînements ont mobilisé 512 processeurs graphiques en même temps. Les 22 000 heures de calcul utilisées auraient coûté de 25 000 à 40 000 dollars.
Sans cet accès, reconnaît Isheanesu Misi, le projet aurait été « mort-né ». C’est aussi sa limite : combien d’équipes africaines peuvent compter sur un tel soutien ? La question de la reproductibilité de ce type de projet, sans calcul subventionné, reste entière.
Les données synthétiques, un palliatif
Pour compenser le manque de textes réels, Vambo a eu largement recours à des données synthétiques, c’est-à-dire des textes générés par d’autres modèles d’IA. Cela a permis de combler les trous et d’orienter le modèle vers des capacités précises, comme l’utilisation d’outils. Mais le résultat n’est pas parfait : la grammaire des réponses est parfois « proche mais imparfaite », reconnaît le directeur technique.
Le manque est frappant pour des langues parlées par des millions de personnes. Selon Isheanesu Misi, l’isindebele et le pidgin nigérian disposent de « presque aucune ressource » pour l’IA. Or ce sont précisément les langues dans lesquelles les applications seraient les plus utiles, pour la santé, l’éducation, l’agriculture ou les services financiers, auprès de personnes qui ne maîtrisent ni l’anglais ni le français.
Pourquoi les grands modèles parlent mal ces langues
Les grands modèles d’IA sont entraînés sur des volumes gigantesques de textes collectés en ligne. Or Internet est massivement anglophone, puis dominé par une poignée de grandes langues. Les langues africaines, même parlées par des dizaines de millions de personnes, y sont très peu représentées, car une grande partie de leur usage est orale, et leurs textes écrits sont peu numérisés. Un modèle généraliste apprend donc ces langues à partir de fragments, avec des erreurs de grammaire, de vocabulaire et de ton.
La conséquence est concrète : un assistant qui répond correctement en anglais peut donner une réponse approximative, voire fausse, en haoussa ou en isizoulou. Pour un service de santé ou d’information agricole, ce n’est pas un détail. D’où l’intérêt de modèles conçus spécifiquement pour ces langues, même plus petits, qui peuvent faire mieux sur leur terrain que des géants généralistes.
Un modèle ouvert, pour que d’autres construisent dessus
Vambo présente MORENA comme une infrastructure plutôt que comme un produit fini. Les poids du modèle sont publiés sous licence Apache 2.0, qui autorise l’usage commercial ; le corpus d’entraînement, lui, n’a pas encore été publié. Des versions plus petites, de 0,5 et 0,2 milliard de paramètres, sont conçues pour fonctionner sur des machines modestes. L’idée : permettre à des développeurs d’adapter le modèle à la fintech ou à l’éducation sans supporter le coût d’un entraînement complet.
« Si tout le monde essaie de construire un modèle à partir de zéro, c’est prohibitif, compliqué et long. Mais un affinage peut coûter une centaine de dollars, voire moins. »
Isheanesu Misi, Vambo AI
Un mouvement plus large
MORENA n’est pas isolé. Le continent compte plus de 2 000 langues, dont beaucoup ont très peu de textes et d’enregistrements numérisés. Au Nigeria, le modèle multilingue N-ATLAS est développé autour des langues locales. Google a publié avec son projet WAXAL un ensemble ouvert de données vocales couvrant 21 langues d’Afrique subsaharienne. Des chercheurs et des start-up collectent des enregistrements et produisent des données synthétiques pour combler les lacunes.
La puissance de calcul, elle, devient plus accessible. Au Nigeria, la plateforme UduTech développe une offre de calcul par processeurs graphiques et vient de s’associer au sud-coréen BARO AI pour élargir l’approvisionnement en processeurs pour les gouvernements, entreprises et chercheurs africains. La société Chipmango conçoit des puces et forme des ingénieurs.
Ces initiatives posent aussi une question de propriété. Quand une grande entreprise étrangère collecte des données vocales dans des communautés africaines, qui en garde le contrôle, et qui profite des produits construits dessus ? Les licences ouvertes, comme celles choisies par Vambo pour son modèle ou par Google pour WAXAL, permettent à tous de s’en servir. Mais les communautés qui fournissent leur voix et leurs textes demandent de plus en plus à être associées aux décisions et aux bénéfices, un débat que les chercheurs africains en traitement des langues portent depuis des années.
La couche de données, aussi stratégique que les GPU
La leçon de MORENA dépasse Vambo. Les ambitions africaines en matière d’IA se mesurent souvent au nombre de processeurs graphiques et de centres de données annoncés. Mais sans données, ces machines tournent à vide, ou produisent des modèles qui parlent mal les langues du continent. Collecter, nettoyer, documenter et partager les données linguistiques à grande échelle est un travail moins spectaculaire que l’inauguration d’un centre de calcul. C’est pourtant lui qui décidera si l’IA parle un jour vraiment aux Africains dans leurs langues, et pas seulement dans celles de leurs anciens colonisateurs.
- Building African-language AI is easier than finding the data, TechCabal.
- African Development Bank Launches Free AI Training for Public Officials Across Africa (AI Hub du PNUD), TechAfrica News.
Une erreur ? Écrivez à infos@novotech.blog. Les corrections sont signalées en fin d'article.